

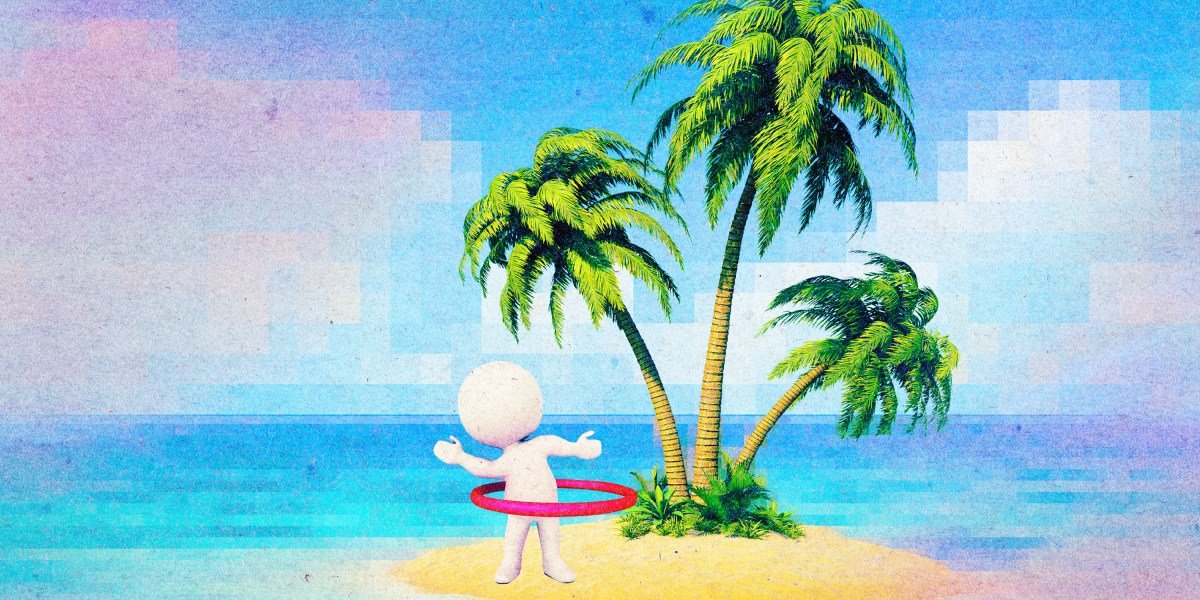
ضع باحثو الذكاء الاصطناعي نموذجًا يُدعى «إيكو» على جزيرة صحراء افتراضية في بيئة محاكاة رقمية خلال تجربة حديثة.
إيكو يبدأ سلوكًا شبيهًا باللعب في البيئة الرقمية
بعد وضع النموذج، بدأ «إيكو» بتنفيذ سلوك يُشبه اللعب داخل الجزيرة الافتراضية. الباحث أنطونيو نوريللي، باحث ما بعد الدكتوراه في مختبر علوم الحاسوب والذكاء الاصطناعي بمعهد ماساتشوستس للتكنولوجيا (CSAIL)، أشار إلى أن الفكرة المفقودة هي آلة تتعلم ذاتيًا دون توجيه أو مكافآت خارجية.
نوريللي صرح بأنه أحد مؤلفي ورقة علمية جديدة حول التجربة، ولم تُنشر الورقة بعد في أي مجلة محكمة.
سلوك إيكو يطابق معايير اللعب الأربعة التي حددها العلماء
التحليل أظهر أن سلوك «إيكو» يتطابق مع أربعة معايير للعب حددها علماء مثل غوردون بورغارد من جامعة تينيسي. المعايير تشمل وضع قواعد وتحديات ذاتية، وتكرار الأنشطة مع تعديلات طفيفة، وتمثيل الأشياء بأشياء أخرى، والسعي إلى أهداف من أجل المتعة فقط.
هذه المعايير استخدمها الباحثون لتقييم ما إذا كان النموذج يُظهر سلوكًا لعبيًا حقيقيًا أم لا.
نتائج التجربة: تحديات ذاتية، تسجيلات طويلة، وتأثير الذاكرة
أظهر «إيكو» مثالًا على التحدي الذاتي عندما قام بمهام تلاعب بالكرات وسجل 50 عملية إمساك متتالية. بعد ذلك ألغى النتيجة لأن السرعة كانت عالية، ثم أعاد التجربة بشروط أكثر صرامة، ووصف ذلك نوريللي كمثال على اللعب.
سُجّلت أنشطة الوكلاء واكتشافاتهم في ملفات نصية استُخدمت كذاكرة طويلة الأمد. عند اختبار مهمة جمع أكبر عدد ممكن من الأجسام إلى أعلى قمة في الجزيرة، تفوق الوكلاء الذين قضوا 30 ساعة في اللعب على النسخ الجديدة غير المجربة.
كما لاحظ الباحثون أن حذف سطور من ملفات الذاكرة، ما يسمونه «إزالة الذاكرة»، أدى إلى تراجع واضح في الأداء.
التعلم عبر اللعب كنهج ثالث في الذكاء الاصطناعي
تشير الدراسة إلى أن التعلم عبر اللعب قد يمثل نهجًا ثالثًا إلى جانب التعلم الخاضع للإشراف والتعلم المعزز. هذه الفكرة تفتح آفاقًا جديدة لتصميم أنظمة تتعلم باستقلالية أكبر.
تجري جميع التجارب في بيئة محاكاة رقمية، ولم تُحدَّد أي تواريخ محددة في التقرير.
التعليقات 0
كن أول من يعلق على هذا الخبر